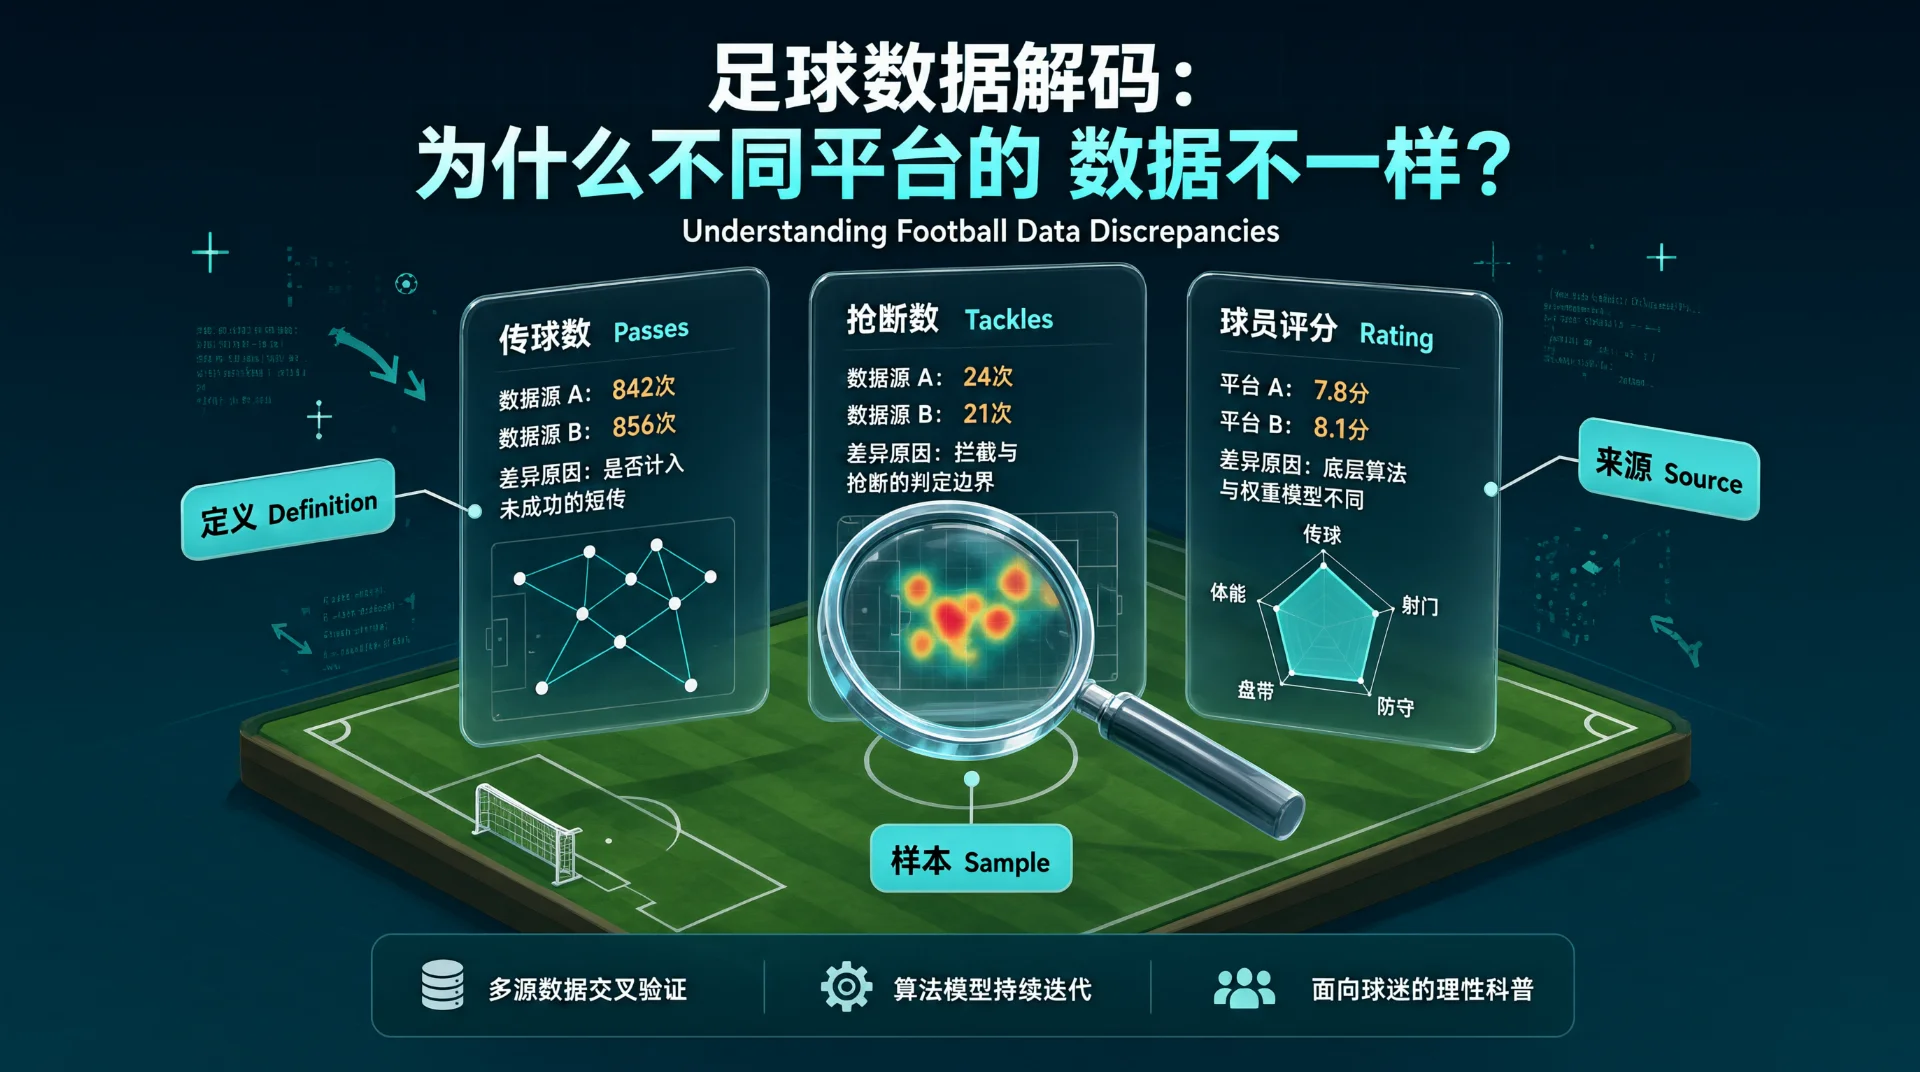
看比赛后,球迷常会遇到:同一名后腰在 A 平台拦截次数更高,在 B 平台传球评分更低;同一名边锋的关键传球也不一样。这未必是统计错误,更常见的原因是数据供应商口径不同。理解这一点,能帮助我们更稳妥地看懂球队与球员表现。
同一个动作,可能有不同归类
足球数据的基础是“事件”:传球、射门、抢断、拦截、失误等。听上去清楚,但细节定义并不总是一致。比如一次防守动作,甲方可能把“伸脚断球但未控住”记为抢断尝试,乙方则要求断球后本方获得球权才算成功;一次向前传球被对手挡出,有的平台记为传球失败,有的更强调传球选择,将其归入被拦截。定义不同,总数自然不同。
进攻端同样如此。什么算“关键传球”,有的只看是否形成射门,有的还会考虑射门质量与后续发展;什么算“成功过人”,是否要求继续控球、是否把被犯规也算入,也会有差别。看到数字先别急着比较,先问一句:这个指标是怎么定义的?
采集方式决定数据边界
采集方式也会影响结果。人工记录、视频识别、光学追踪等方式对细节的捕捉能力不同,更新速度也不同。大赛、五大联赛通常覆盖更完整,低级别联赛或杯赛可能滞后缺漏。若两家供应商覆盖比赛范围不一致,那么“赛季平均”“近十场”等汇总数字就缺少直接可比性。
采集边界还会影响球队判断。例如分析压迫强度,如果某平台只统计前场特定区域的防守动作,另一平台统计全场范围,得出的压迫次数就会不同。再如门将出击、中卫带球推进,若统计没有包含门将活动范围,球队组织方式可能被简化成几个普通传球数字。
模型指标更需要看说明
基础事件之外,模型化指标如球员评分、预期进球、预期助攻、传球威胁值,能把复杂表现压缩成可比较的线索,但更依赖建模思路。模型选择哪些变量、如何赋予权重、如何处理比赛状态,都会改变结果。
因此,跨平台直接比较模型指标要谨慎。A 平台的 7.2 分和 B 平台的 7.2 分未必含义相同;同一名球员的威胁传球也可能因输入变量不同而高低不一。更稳妥的做法,是在同一来源内纵向比较,或先了解指标说明,再放回比赛场景。各平台通常会在官网公开定义与范围,例如 FBref、Opta、StatsBomb,读者可把说明当作阅读数据的第一步。
普通读者可以怎样使用
- 先看来源与定义:确认指标统计的是动作结果、球权变化,还是后续影响。
- 优先同口径比较:同一平台、同一赛事、同一时间段的数据更适合放在一起看。
- 结合角色与样本:边后卫传中、后腰拦截、前锋无球跑动,不能脱离职责和出场时间。
- 把数据当线索:数字能提示问题,但阵型、对手强度、比分状态仍需一并考虑。
足球数据的价值,不在于给出唯一答案,而在于帮助我们提出更好的问题。面对不同供应商的数字,与其争论谁对谁错,不如先弄清它们各自如何记录比赛。看懂口径差异,数据才会从简单的评分表,变成理解球队运作与比赛表现的入口。